library(GA) # 遗传算法
library(tidymodels)
library(finetune) # tune包的扩展包,提供了更多的调参方法
library(probably) # 概率预测
library(mirai) # 并行计算

tidymodels_prefer()
theme_set(theme_bw())
daemons(parallel::detectCores())41 迭代搜索
注记需求说明
为降低示例复杂度,本章将使用包含数值预测变量的模拟分类数据集。通过模拟系统生成 1000 个样本,该数据集包含线性、非线性和交互特征,且类别分布较为均衡。我们将按 3:1 的比例划分训练集和测试集,并采用 10 折交叉验证。此外,本章使用xgboost( 章节 55 中有详细介绍)作为模型,来调整其多个超参数,并设定一个validation = 0 的参数(虽然这里我们不会用到这个这是,但其会用于提前停止模型的训练)。
set.seed(2783)
sim_dat <- sim_classification(1000) # 生成模拟数据集

set.seed(101)
sim_split <- initial_split(sim_dat)
sim_train <- training(sim_split)
sim_test <- testing(sim_split)
sim_rs <- vfold_cv(sim_train)

# sepcify xgboost model
bst_spec <- boost_tree(
  mtry = tune(),
  tree_depth = tune(),
  trees = tune(),
  learn_rate = tune(),
  min_n = tune(),
  loss_reduction = tune(),
  sample_size = tune()
) |>
  set_engine("xgboost", validation = 0) |>
  set_mode("classification")

# specify workflow
bst_wflow <- workflow(class ~ ., bst_spec)

# specify parameter ranges
bst_params <- bst_wflow |>
  extract_parameter_set_dials() |>
  update(
    mtry = mtry(range = c(3, 15)), # 更新 mtry 参数范围
    trees = trees(range = c(10, 500))
  )

# sepcify metrics and tune-grid
cls_mtr <- metric_set(brier_class, roc_auc) # 指定分类任务的评估指标
init_grid <- grid_space_filling(bst_params, size = 15) # 生成初始网格/

set.seed(21)
init_res <- bst_wflow |>
  tune_grid(
    resamples = sim_rs,
    grid = init_grid,
    metrics = cls_mtr,
    control = control_grid(save_pred = TRUE)
  )
后续的章节将以此为基础,介绍如何使用三种迭代搜索方法来优化模型的超参数。
调优参数数量较多时,模型计算成本会大幅升高,超出合理范围。更为突出的局限在于,前文所述的各类加速策略(如 小节 40.3 子模型简化方法)将失去适用条件。竞速法虽具备计算高效的优势,但面对超大样本训练集时,采用单一验证集评估优于多重重采样方案,该场景下竞速法不再适用。此外,超大数据集还存在工程实操约束:绝大多数并行运算框架需要各计算节点完整载入全部数据至内存,该硬件条件约束会大幅降低并行方案的可行性。 无导数优化算法(Derivative-free techniques)适用于模型调参场景,遗传算法、模拟退火、粒子群优化等均为经典代表,将在 小节 41.1、 小节 41.2 分别介绍前两种算法。当前贝叶斯优化是应用最广泛的迭代式调参工具,相关内容安排于 小节 41.3 节;在此之前,?sec-bayesian-model 节将完整阐释贝叶斯模型的核心内涵。
值得注意的是,梯度下降方法不适合用于模型的超参数调优。可以简单的理解为梯度下降需要“损失函数对参数可导”才能算梯度,而超参数(比如层数、学习率)是离散的/不可导的,没法对它求梯度。
41.1 模拟退火算法(SA)
模拟退火算法(Simulated Annealing, SA)是一种随机搜索算法,灵感来源于固体物理学中金属退火的过程。其核心思想是通过模拟物质在高温下的分子运动,逐渐降低温度,使系统达到能量最低状态,从而找到全局最优解。它能有效工作的关键在于其独特的”取舍”策略,即在搜索过程中允许接受较差的解,以避免陷入局部最优。具体来说:
1. 从一个点出发:即SA算法从一个初始解开始,通常是随机选择的。 2. 生成邻域解:在当前解的邻域内生成一个新的候选解。 3. 关键判断:Metropolis准则,SA算法的核心,它决定了是否接受新的候选解。 - 如果新解的目标函数值优于当前解,则直接接受; - 如果不优于当前解,则以一定概率接受新解,这个概率与温度和目标函数值的差异有关。 4. 缓慢降温:算法在一个温度下会进行多次“探索-判断”的循环。当在这个温度下稳定后,温度 T 会按预设的计划略微降低,然后重复第2、3步。 5. 最终收敛:随着温度不断降低,接受更差解的概率(P)也越来越小。最终,在温度足够低时,算法将稳定在全局最优解附近。
在tidymodels中使用finetune包中的tune_sim_anneal()函数进行模拟退火算法的计算。tune_sim_anneal()与tune_grid()的语法非常相似,只有几个参数值得注意:
-
initial,为以下两种情况:- 为一个整数,表示在填充空间设计中应创建并评估多少点,然后再进行。
- 一个来自
tune_grid()或其他tune_*()输出的对象。
-
iter:一个整数,表示最大搜索的迭代次数。 -
control_sim_anneal():用于保存控制日志记录、是否重启或提前停止的选项。
set.seed(381)
as_res <-
  bst_wflow |>
  tune_sim_anneal(
    resamples = sim_rs,
    param_info = bst_params,
    metrics = cls_mtr,
    initial = init_res, # 使用初始网格结果作为起点
    iter = 50, # 最大迭代次数
    control = control_sim_anneal(
      no_improve = Inf, # 提前停止条件,若连续迭代次数内没有改进,则停止搜索
      verbose_iter = TRUE, # 打印每次迭代的结果
      save_pred = TRUE
    )
  )

# show_best()函数用于显示最优结果
show_best(as_res, metric = "brier_class") |>
  select(-.estimator, -.config, -.metric) |>
  relocate(mean) # 将mean列移动到最前面
# A tibble: 5 × 11
mean mtry trees min_n tree_depth learn_rate loss_reduction sample_size
<dbl> <int> <int> <int> <int> <dbl> <dbl> <dbl>
1 0.0778 13 422 2 6 0.0155 2.22e- 8 0.730
2 0.0778 14 430 2 8 0.0178 4.39e- 9 0.714
3 0.0779 14 484 3 6 0.0165 9.10e-10 0.708
4 0.0781 13 430 3 7 0.00955 2.26e- 9 0.683
5 0.0781 13 440 2 8 0.0189 2.49e- 9 0.689
# ℹ 3 more variables: n <int>, std_err <dbl>, .iter <int># 展示模拟退火算法的搜索轨迹
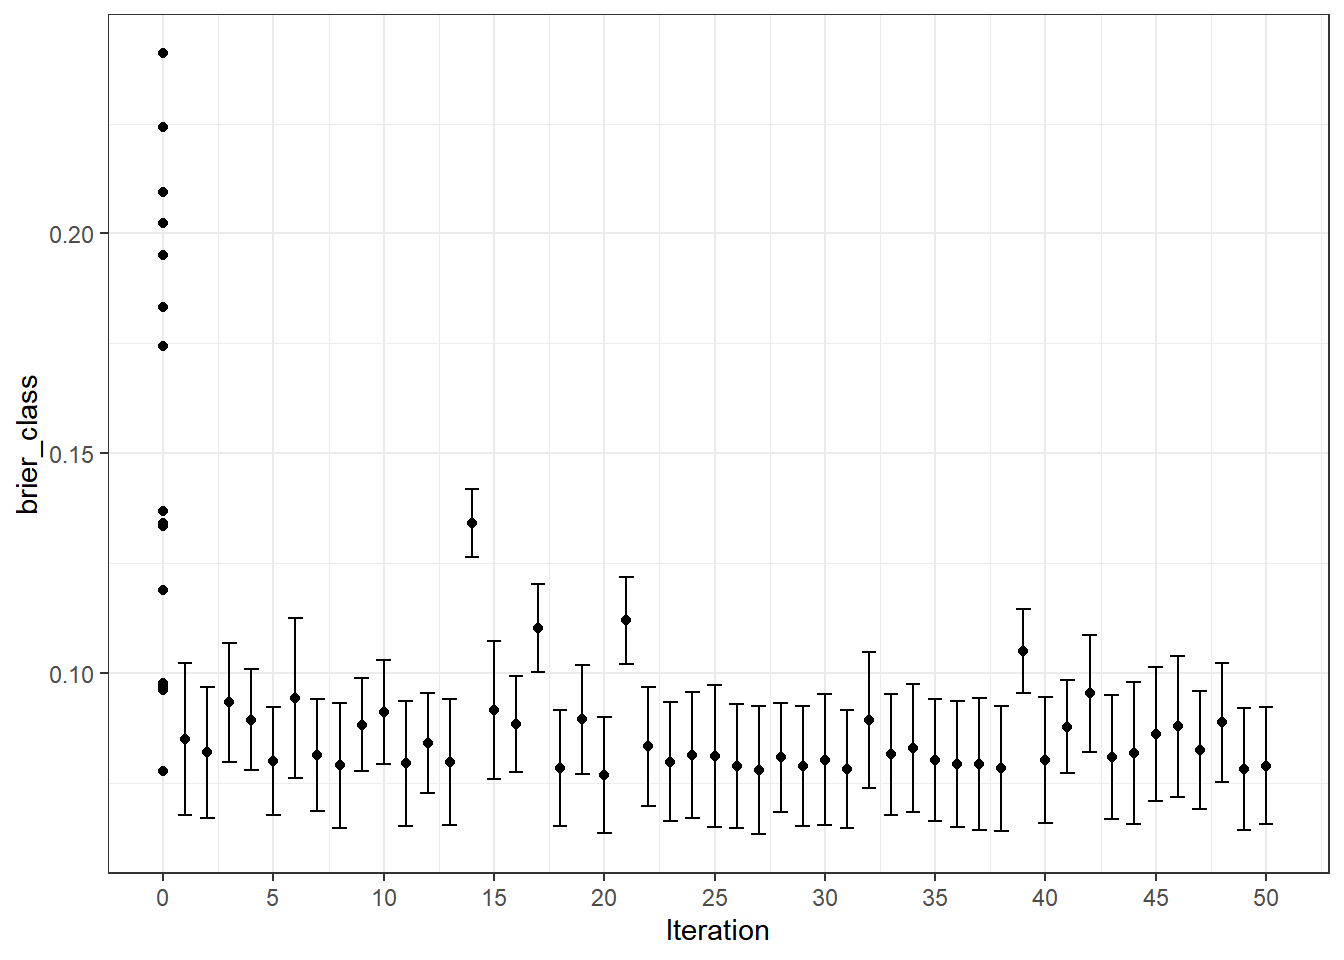
autoplot(as_res, metric = "brier_class") # 绘制参与与`brier_class`指标相关的搜索轨迹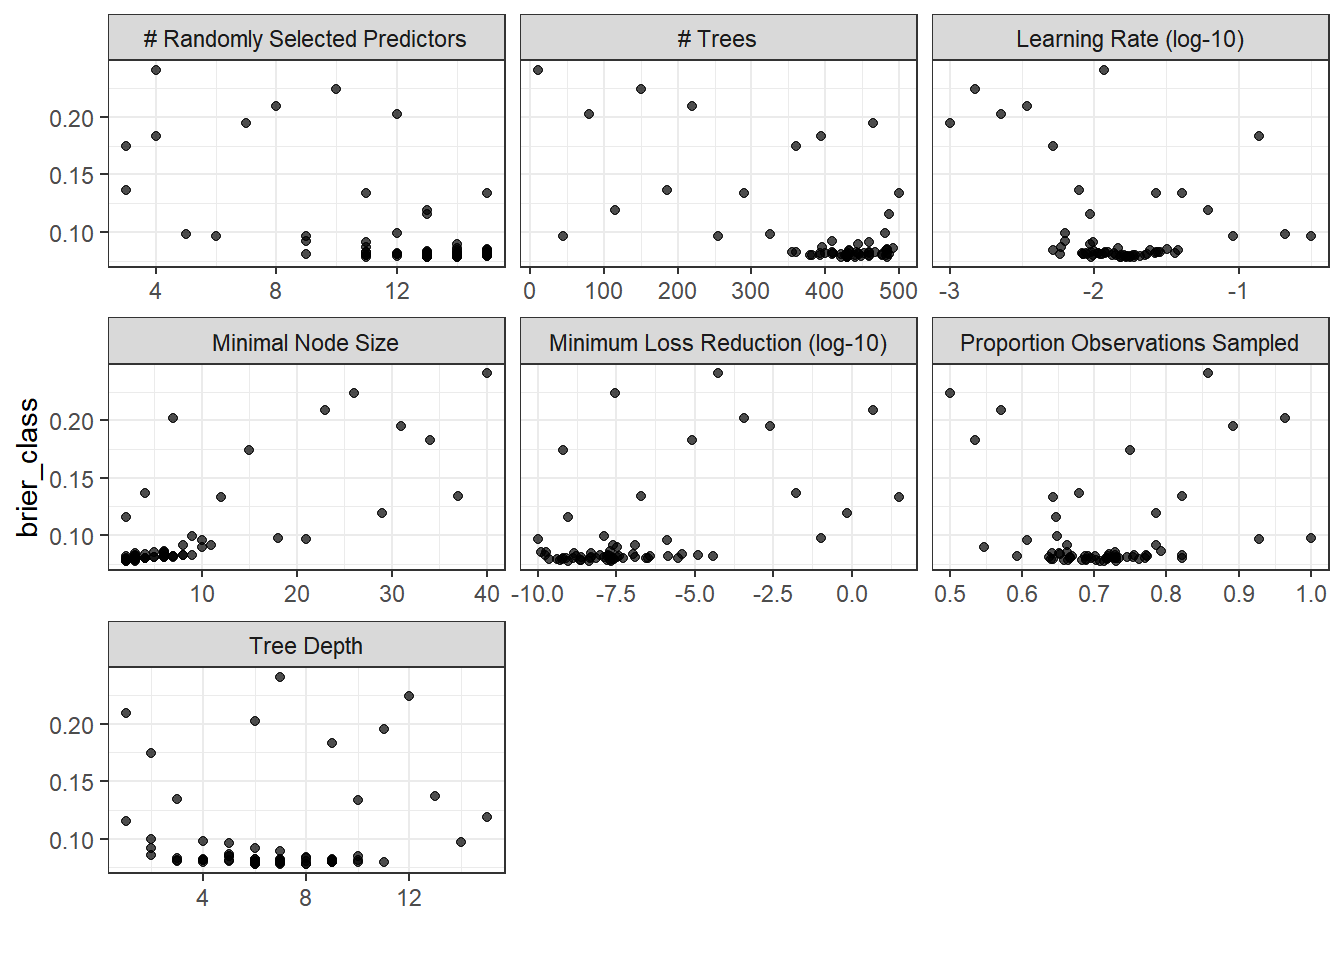
autoplot(as_res, metric = "brier_class", type = "parameters") # 搜索过程中各参数值的变化情况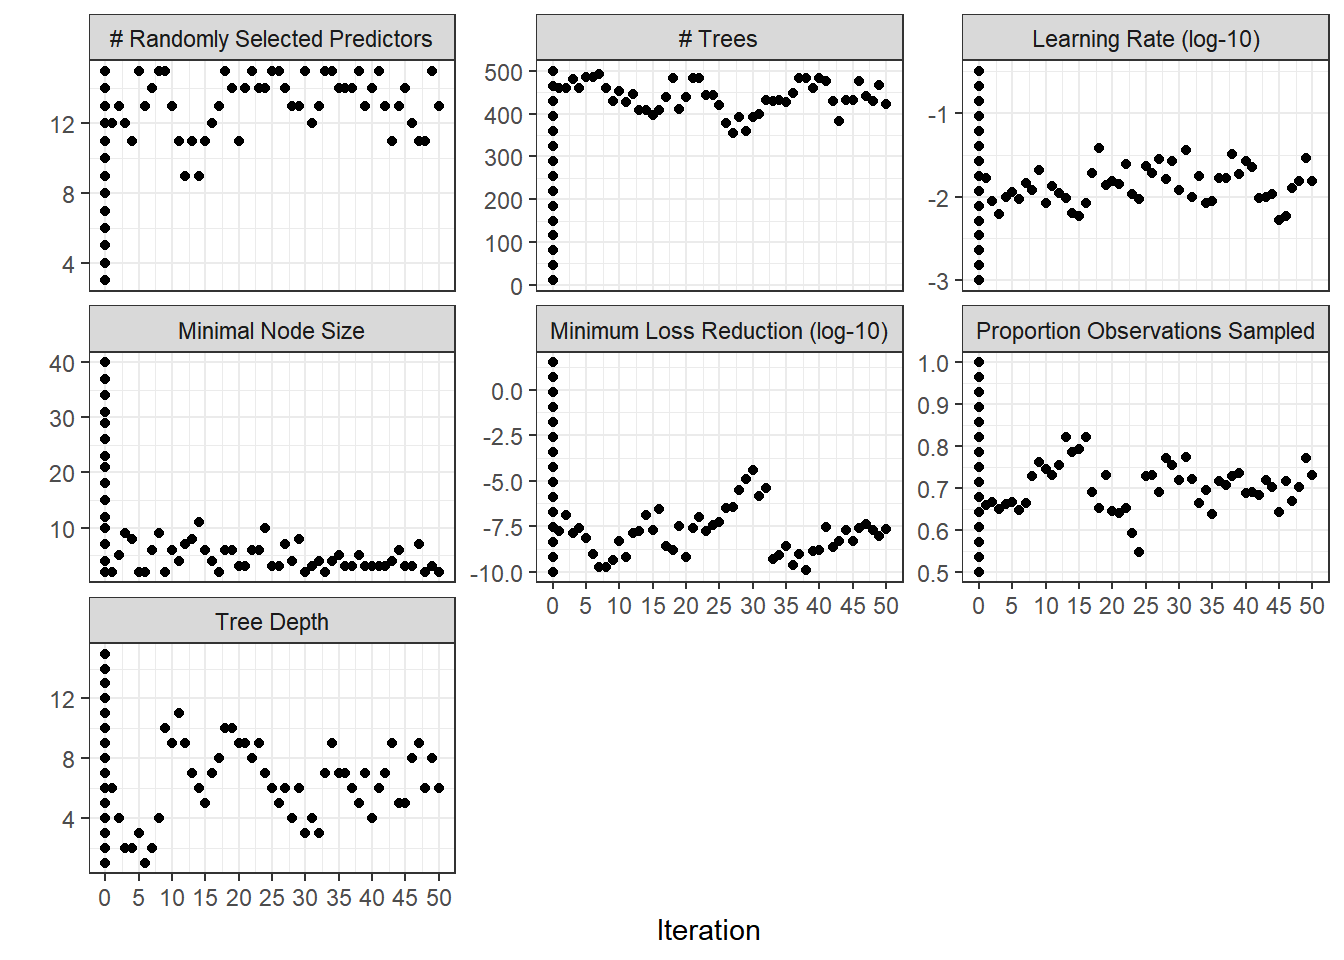
autoplot(as_res, metric = "brier_class", type = "performance") # 搜索过程中性能/评估指标的变化情况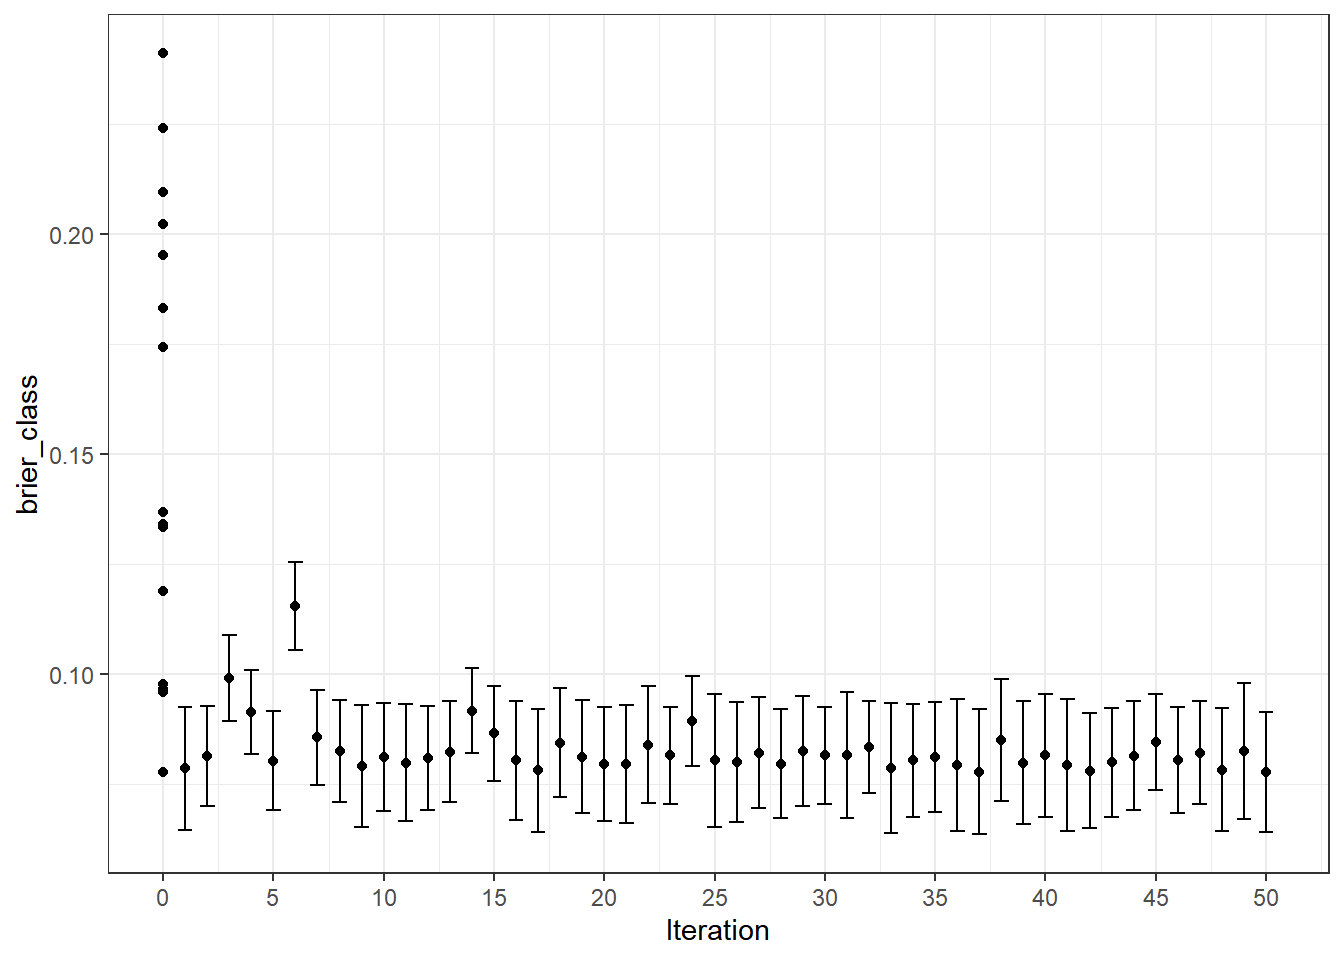
如果我们使用了control_sim_anneal()函数中的save_workflow = TRUE参数,则可以在搜索过程中保存每次迭代的工作流对象。这样我们就可以直接使用fit_best()来确定指标值最佳的候选模型,并将该模型拟合到训练集上。
41.2 遗传算法
tidymodels并未提供基于遗传算法做模型优化的应用程序接口(API)或内置函数。不过,只要全部超参数均为数值型,可使用下方未得到官方支持的自定义代码实现该功能。我们将借助 GA包完成计算,具体可参看此链接。
提示Side-bar-贝叶斯模型
先验:看数据前,觉得治愈率大概在0.4-0.6之间;似然:通过试验得到100人中有80人治愈;后验:综合先验与似然试验,得到治愈率后验集中在0.6附近,且比先验更窄,更稳定。
41.3 贝叶斯优化
- 贝叶斯优化技术是使用当前的重抽样结果创建一个预测模型,来探索那些还未被评估的超参数。
- 被探索出的超参数会继续使用重抽样进行评估,并创建另一个模型。
- 以上过程会经过一定次数迭代,或模型性能不在发生改变为止。
- 贝叶斯优化最常用的技术是高斯过程模型(Gaussian Process Regression, GP),它是一种非参数的贝叶斯方法,能够为每个预测提供不确定性估计。
- GP的核心思想是通过定义一个协方差函数(或核函数)来描述数据点之间的相关性,从而对未知函数进行建模。
- 通过这种方式,GP不仅可以预测函数值,还可以量化预测的不确定性,这对于优化问题尤为重要,因为它可以帮助我们在探索和利用之间取得平衡。
- 在贝叶斯优化中,GP模型会根据已有的超参数评估结果,预测未评估的超参数组合的性能,并提供不确定性估计。然后,优化算法会选择那些具有潜在高性能且不确定性较大的超参数组合进行下一轮评估,从而逐步逼近全局最优解。
tidymodels中使用tune::tune_bayes()函数进行贝叶斯优化,且默认使用期望改进3作为采集函数4
set.seed(221)
bo_res <- bst_wflow |>
  tune_bayes(
    resamples = sim_rs,
    param_info = bst_params,
    metrics = cls_mtr,
    initial = init_res, # init_res的网格数应该比超参数的数量多,最好在2倍左右。本例中有7个超参数组合,初始网格应该为7*2≈15
    iter = 50,
    control = control_bayes(
      no_improve = Inf,
      verbose_iter = TRUE,
      save_pred = TRUE
    )
  )

# 可视化
autoplot(bo_res, metric = "brier_class") # 超参数变化情况,衡量指标为brier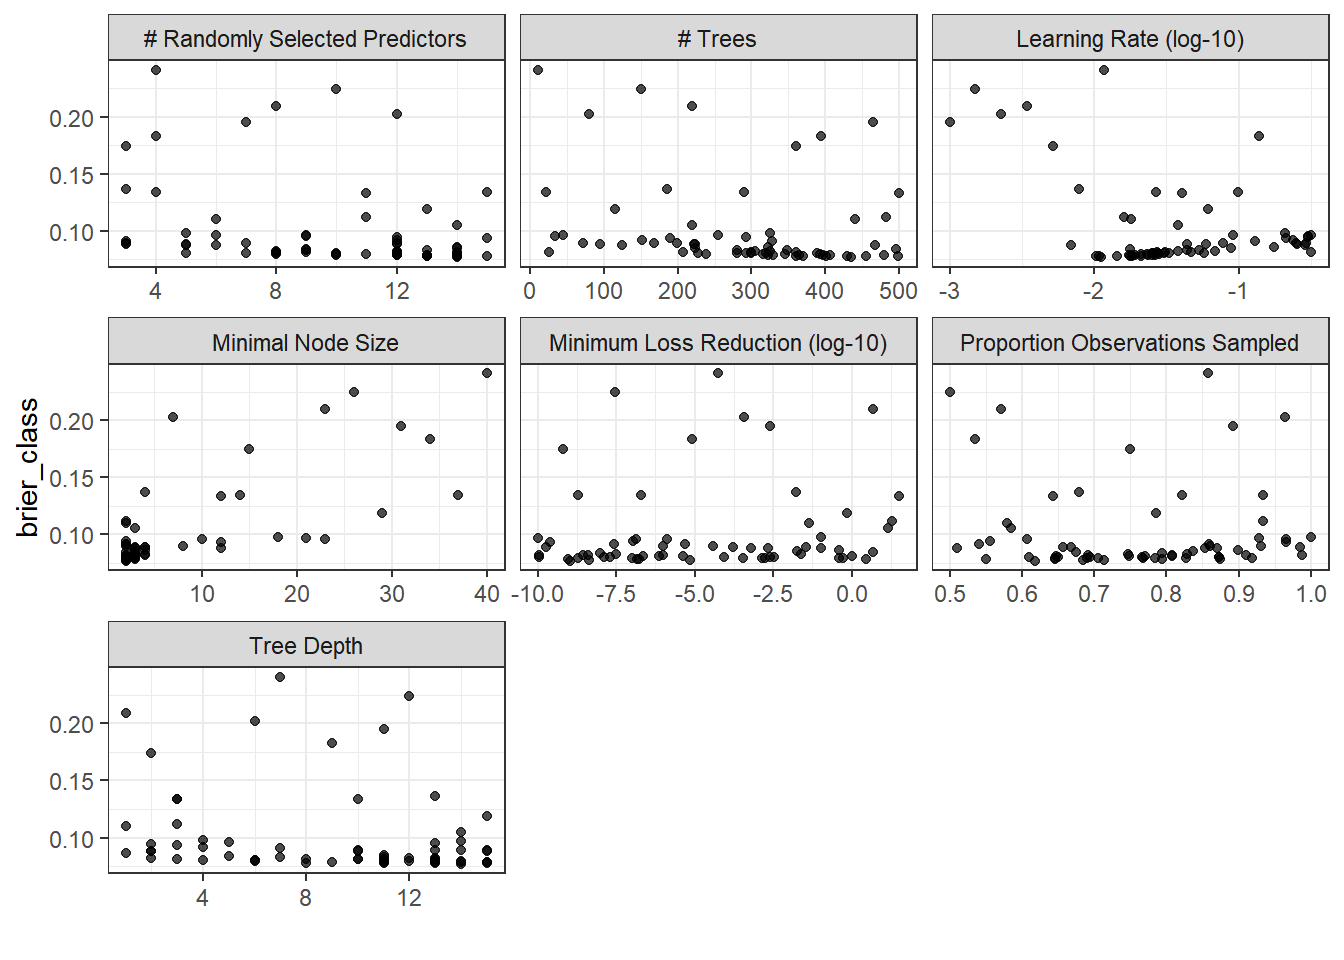
autoplot(bo_res, metric = "brier_class", type = "parameters")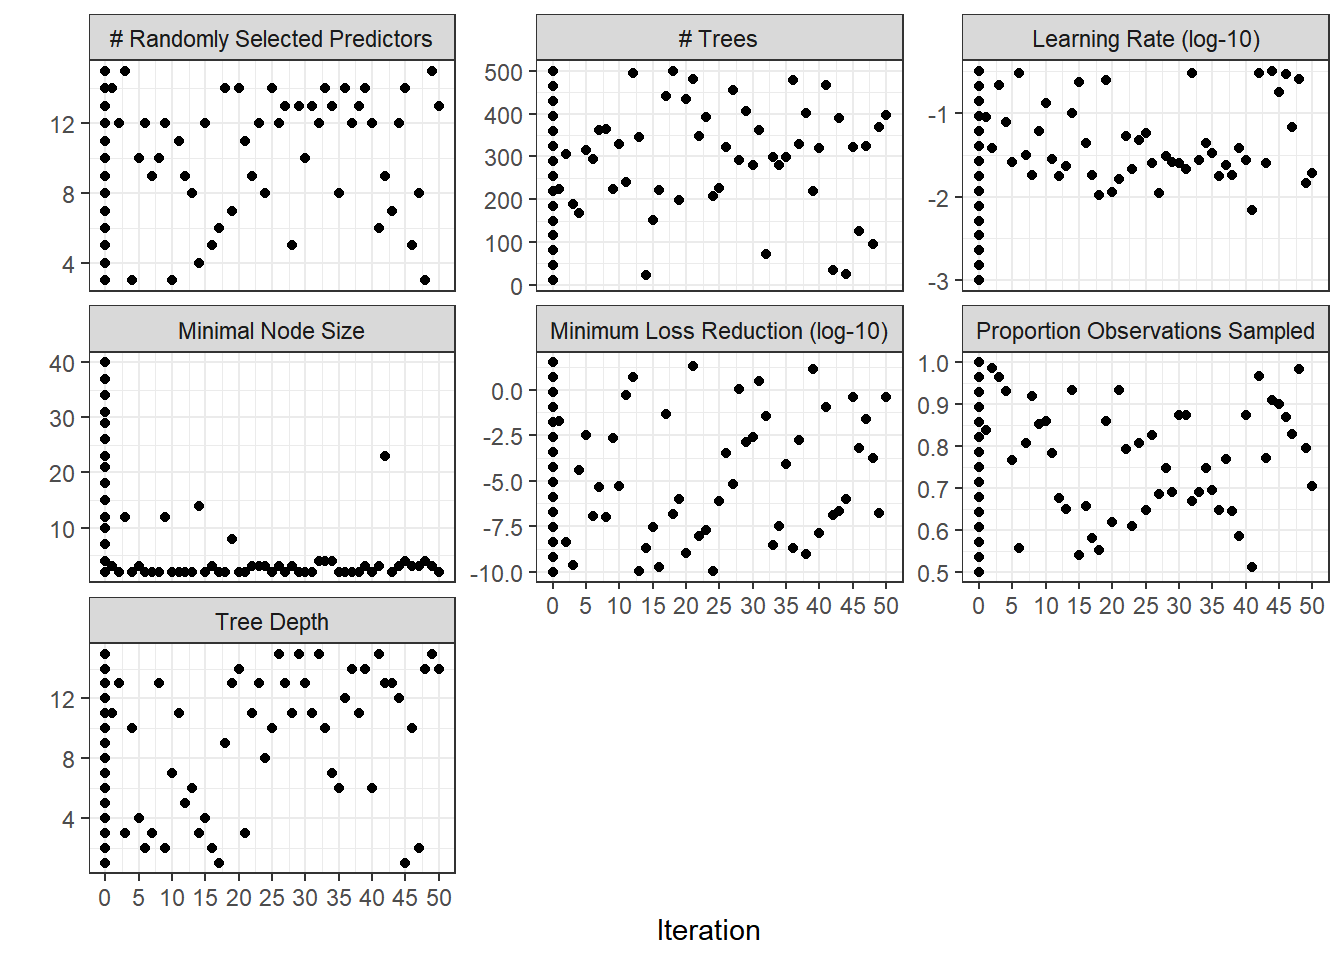
autoplot(bo_res, metric = "brier_class", type = "performance")